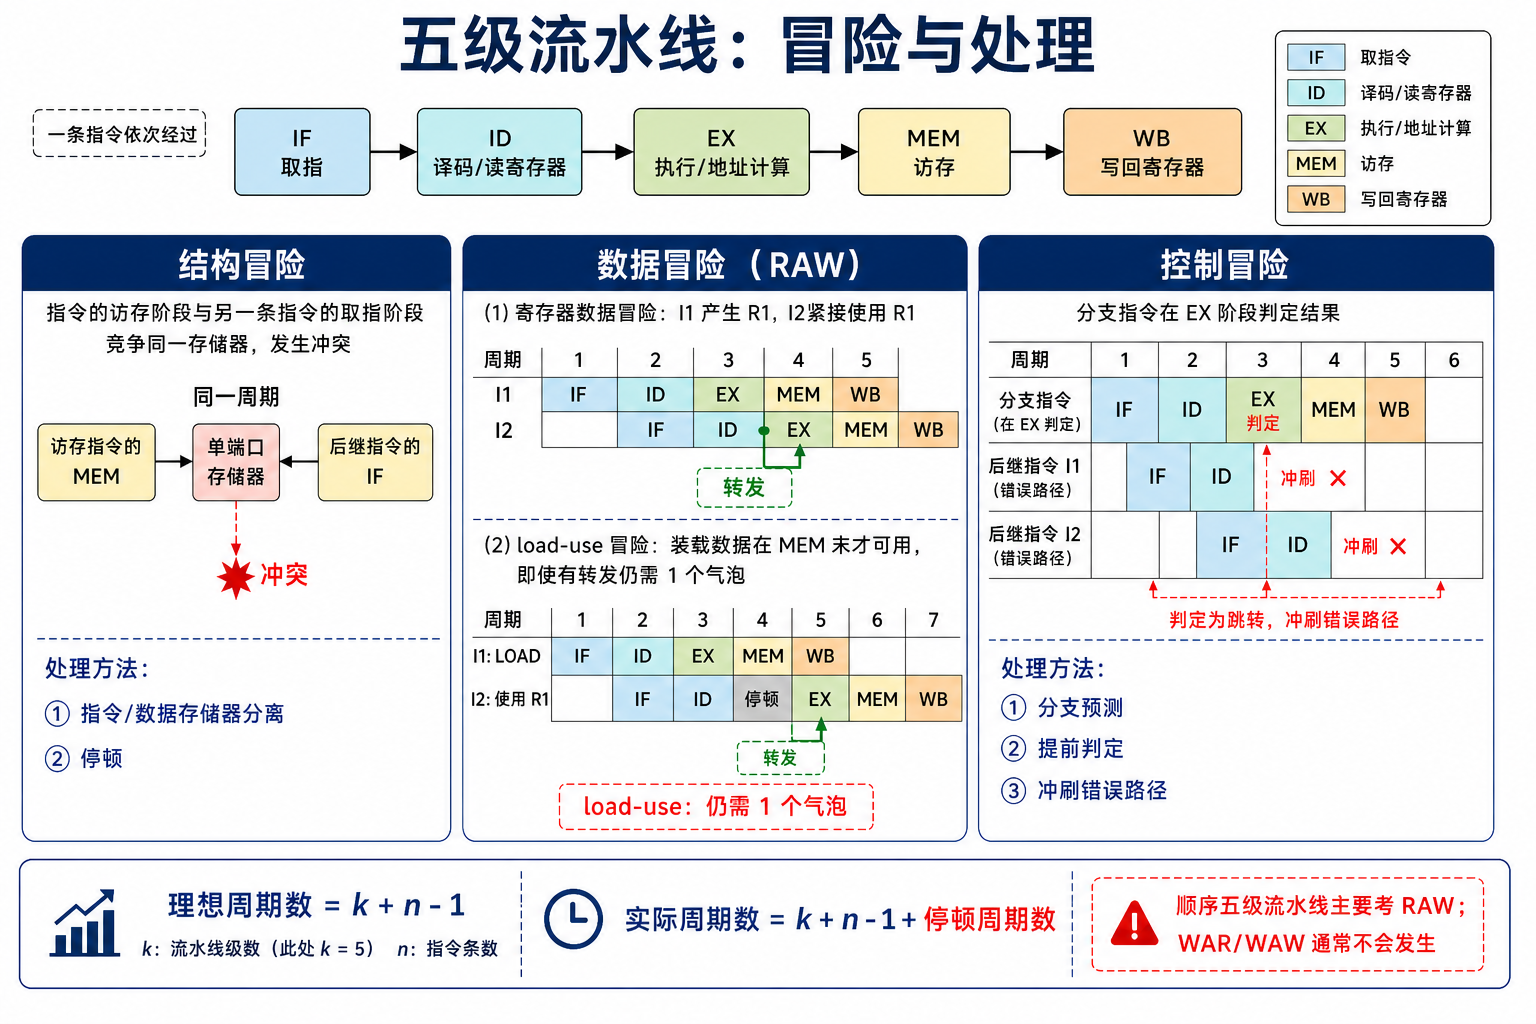
流水线的冒险与处理
上一节的时空图假设每拍都能顺利往前推进一格。这一节讨论推不动的时候。
推不动只有三个原因,而这三个原因正好对应流水线成立的三个条件被破坏(5.6.1):
| 冒险 | 破坏了哪个条件 | 一句话 |
|---|---|---|
| 结构冒险 | 各段功能部件独立 | 两条指令要用同一个部件 |
| 数据冒险 | ——(新问题) | 后一条要用前一条还没算出来的值 |
| 控制冒险 | ——(新问题) | 不知道下一条该取哪一条 |
三类冒险的处理手段可以归成一张更根本的表:每一种手段都把代价推到
机制
一、结构冒险(资源冲突)
两条指令在同一拍需要同一个硬件部件。
经典例子:若只有一个存储器,第 4 拍时 I1 在 MEM 段访存、I4 在 IF 段取指——同一个存储器要被读两次。
| 解决手段 | 做法 | 代价 |
|---|---|---|
| 停顿(插气泡) | 让后面的指令等一拍 | CPI ↑ |
| 资源重复 | 分离指令存储器和数据存储器 | 硬件成本 ↑ |
| 资源分时 | 一拍内前半读、后半写(寄存器堆常用) | 对部件速度要求 ↑ |
主流做法是资源重复——这就是 5.6.2 说的分离 I-Cache / D-Cache。
寄存器堆用的是资源分时:WB 段在时钟前半拍写、ID 段在后半拍读,于是同一拍里”写在前读在后”,后面的指令能读到刚写的值。这个小设计能消掉整整一拍的数据冒险,是很多题目里”距离 3 的相关不需要停顿”的原因。
二、数据冒险
三种相关,五段流水线里只有一种真的会发生
| 类型 | 全称 | 含义 | 五段流水线里 |
|---|---|---|---|
| RAW | 写后读 | 后一条要读前一条写的值 | 真相关,会发生 |
| WAR | 读后写 | 后一条要写前一条读的位置 | 不会——顺序流水,读总在写之前 |
| WAW | 写后写 | 两条都写同一位置 | 不会——都在 WB 段按序写 |
WAR 和 WAW 只在乱序执行的流水线里才会出现(5.6.5),处理手段是寄存器重命名。408 的五段流水线题目里只需要处理 RAW。
RAW 冒险的距离计算
关键事实(5.6.2):WB 段写寄存器,ID 段读寄存器,相隔 3 个段。
I1: ADD R1,R2,R3    IF  ID  EX  MEM  WB
I2: SUB R4,R1,R5        IF  ID  ...          ← 第 3 拍读 R1,但 R1 第 5 拍才写
I3:                         IF  ID  ...      ← 第 4 拍读
I4:                             IF   ID      ← 第 5 拍读
| I2 与 I1 的距离 | I2 读寄存器的拍 | 是否冲突 | 要停几拍 |
|---|---|---|---|
| 相邻(距离 1) | 第 3 拍 | ✅ | 2 拍(无转发) |
| 距离 2 | 第 4 拍 | ✅ | 1 拍 |
| 距离 3 | 第 5 拍 | 看是否”先写后读” | 0 或 1 |
| 距离 ≥ 4 | 第 6 拍及以后 | ❌ | 0 |
距离 3 那一行是最常考的一处:若寄存器堆采用”前半拍写、后半拍读”,则不需要停顿;若题目没说,按需停 1 拍。做题时要看题目给的假设。
数据冒险的四种处理手段
这是本节的核心表——四种手段,代价落在四个不同的地方。
| 手段 | 谁做 | 什么时候做 | 代价落在 | 能否完全解决 |
|---|---|---|---|---|
| 硬件阻塞(stall / 气泡) | 硬件 | 运行时 | CPI ↑ | ✅ 但慢 |
软件插入 nop | 编译器 | 编译时 | IC ↑(代码变长) | ✅ 但慢 |
| 数据转发(旁路 forwarding) | 硬件 | 运行时 | 硬件成本 ↑ | ✅ 大部分情况 |
| 指令调度(编译器重排) | 编译器 | 编译时 | 无(若能找到无关指令) | ❌ 找不到就不行 |
疑问点:为了解决数据相关可以插入
nop指令,是编译时就插进去的吧?还有哪些操作是的,
nop由编译器(或汇编器)在编译时插入——这一条判断完全正确。而”还有哪些”这个问题,最有价值的答法不是罗列,是看每种手段把代价推到了哪里。四种手段,两个维度:谁来做(软件/硬件)、代价落在哪。
手段 软件 / 硬件 代价落在 的哪个因子 软件插 nop编译时,软件 ↑——多了几条真实的指令, 不变 硬件阻塞 运行时,硬件 ↑——指令数不变,但有些拍什么都没完成 数据转发 运行时,硬件 都不变,硬件成本 ↑ 指令调度 编译时,软件 理想情况都不变——用真正有用的指令填上那几拍 前两种的效果完全一样,差别只在这几拍空转记在谁头上。 插 3 条
nop,加 3;硬件停 3 拍, 相应上升。跑得一样慢,但公式上的账记在不同的因子里——这是1.3.1 计算机的主要性能指标三因子在本章最直接的一次应用。 软件方案的真正好处是硬件可以更简单:早期 MIPS 干脆不做冒险检测电路,把保证正确性的责任完全交给编译器——编译器算不对就出错。这种设计叫”软件互锁”,名字来源就是”硬件没有互锁(interlock)“。MIPS 这个缩写的原始展开 “Microprocessor without Interlocked Pipeline Stages” 说的就是这件事。
但真正的主力是第三种:数据转发。
观察一下时空图:I1 的结果在 EX 段末尾就已经算出来了(存在 EX/MEM 段间寄存器里),只是还要等两拍才写回寄存器堆。既然值已经有了,为什么一定要绕道寄存器堆?
I1: ADD R1,R2,R3   IF  ID  EX ─┐ MEM  WB
                                │ 直接送过去
I2: SUB R4,R1,R5       IF  ID ←┘ EX  MEM  WB
在 EX/MEM 寄存器和 ALU 输入端之间加一条旁路,把结果直接送给下一条指令——这就是转发(forwarding / bypassing)。代价是若干个 MUX 和一套冒险检测逻辑,换来的是绝大多数 RAW 冒险零停顿。
转发有一个解决不了的情况,而且它一定会考:
I1: LW  R1,0(R2)   IF  ID  EX  MEM ─┐ WB
                                     │ 数据到 MEM 段末尾才出来
I2: ADD R3,R1,R4       IF  ID  EX ←──┘ 但 EX 段在前一拍就要用
LW的数据要到 MEM 段结束才从存储器读出来,而下一条指令的 EX 段比它早一拍——时间上倒流了,转发做不到。 这叫 load-use 冒险,必须停顿 1 拍(然后再转发)。判据一句话:转发能把”结果产生的段”提前接到”需要它的段”,但产生不能晚于需要。
ADD在 EX 末产生、下一条 EX 初需要 → 可以;LW在 MEM 末产生、下一条 EX 初需要 → 不行。第四种手段——指令调度——是最优的,因为它不浪费任何东西。 编译器把附近与之无关的指令挪到冒险的两条之间:
原始:  LW  R1,0(R2)         调度后: LW  R1,0(R2)
        ADD R3,R1,R4                  SUB R7,R8,R9   ← 无关指令填进来
        SUB R7,R8,R9                  ADD R3,R1,R4
停顿变成了有用的工作。 代价是编译器要做依赖分析,而且附近未必有无关指令可挪——找不到就只能退回插
nop或硬件停顿。4.3.3 说的编译器优化(归纳变量替换等)和这是同一类工作。
疑问点:
nop是执行一个时钟周期,还是一个完整的指令周期两个都对——但它们回答的是两个不同的问题,而这正是5.6.1 那条”延迟 / 吞吐”区分最好的一道练习题。
问的是 答案 属于 一条 nop自己从进入到离开流水线要多久?5 个时钟周期(走完全部五段) 延迟 插入一条 nop让后面的指令推迟多久?1 个时钟周期 吞吐
nop是一条真正的机器指令,有自己的操作码、要被取指、要被译码、要占段间寄存器、要走完 IF/ID/EX/MEM/WB。它不是”什么都不做”,它是”做了一遍完整的流程,但没有产生任何效果”——不写寄存器、不访存、不改标志位。而它对程序的影响是 1 拍,因为流水线稳定后每拍完成一条指令,多插一条就整体后移一拍。这就是”插
条 nop能填掉需要停顿拍的冒险”的算法依据。 在非流水线的多周期 CPU 上,这个区分不存在——那里
nop就是老老实实占用一个完整的指令周期(若干个时钟周期),既是它的延迟也是它的代价。“延迟和吞吐可以不相等”这件事,是流水线带来的。顺带一提,4.4.1 提过 x86 有多种长度的
nop编码(1 字节到 15 字节),它们的用途不是填流水线,是做代码对齐——让循环入口落在 16 字节边界上,取指效率更高。同一个助记符,两种完全不同的用途。
三、控制冒险
转移指令要到 EX 段(或更早优化到 ID 段)才知道转不转、转到哪。 而在那之前,IF 段已经按顺序取了后面的指令。
经典五段在 EX 段确定 → 浪费 2 拍;优化到 ID 段确定 → 浪费 1 拍。
四种处理手段
| 手段 | 做法 | 代价 |
|---|---|---|
| 阻塞 | 取到分支就停,等结果 | 每次分支都全额浪费 |
| 分支预测 | 猜一个方向继续取,猜错再冲刷 | 猜错才浪费 |
| 延迟槽 | 分支后面固定几条指令无论如何都执行,由编译器填 | 填不满就只能填 nop |
| 提前判断 | 把比较逻辑挪到 ID 段 | 硬件成本 ↑,代价从 2 拍降到 1 拍 |
分支预测
| 类型 | 依据 | 典型 |
|---|---|---|
| 静态预测 | 编译时定死 | 总是不转(最简单);向后转移预测为转(循环的回边) |
| 动态预测 | 运行时根据历史 | 1 位预测器、2 位预测器、分支历史表 BHT |
“向后转移预测为转”这条静态规则的准确率相当高,因为循环的回边总是向后跳,而循环通常要转很多次才退出一次。
2 位预测器比 1 位好在哪——这是常考点:
1 位预测器在循环的最后一次猜错(该退出时它还猜转),而且这次错误会让它翻转,导致下一次进入循环时的第一次又猜错。一个循环错两次。
2 位预测器需要连续错两次才改变预测方向,所以循环退出那一次错了之后不立刻翻转,下次进入循环时仍然预测”转”。一个循环只错一次。
猜错的代价是冲刷(flush):把已经进入流水线的错误路径上的指令全部作废。这和精确异常用的是同一套硬件——都是”把已经在流水线里的指令变成无效”。
三类冒险的处理手段总表
这张表是本节的收口,也是最值得记的一张。
| 冒险 | 手段 | 谁做 | 代价落在 |
|---|---|---|---|
| 结构 | 停顿 | 硬件 | CPI ↑ |
| 资源重复(分离 I/D Cache) | 硬件 | 硬件成本 ↑ | |
| 资源分时(寄存器堆前写后读) | 硬件 | 部件速度要求 ↑ | |
| 数据 | 硬件阻塞 | 硬件 | CPI ↑ |
软件插 nop | 编译器 | IC ↑ | |
| 数据转发 | 硬件 | 硬件成本 ↑ | |
| 指令调度 | 编译器 | 理想情况无代价 | |
| 控制 | 阻塞 | 硬件 | CPI ↑ |
| 分支预测 | 硬件(动态)/ 编译器(静态) | 猜错才有代价 | |
| 延迟槽 | 编译器填 | 填不满则等于插 nop | |
| 提前判断 | 硬件 | 硬件成本 ↑ |
竖着读这张表,能看出一条清楚的规律:
每一种手段都是在”
↑ / ↑ / 硬件成本 ↑“三者之间选一个。没有任何一种手段是免费的,唯一接近免费的是指令调度——而它的前提是”附近真的有无关指令可挪”,这个前提由程序本身决定,编译器无法创造。
边界
边界辨析:转发能解决 / 不能解决
判据:结果产生的段,不能晚于需要它的段。
ADD→ 下一条:EX 末产生,EX 初需要 → ✅ 可转发,零停顿LW→ 下一条:MEM 末产生,EX 初需要 → ❌ load-use 冒险,必须停 1 拍load-use 是必考的那一个例外。
边界辨析:软件插
nop/ 硬件阻塞效果一样,账记在不同因子上:
- 插
nop→↑,代码真的变长了 - 硬件阻塞 →
↑,指令条数没变 一道题问”插入
nop会不会增加指令条数”,答会;问”硬件阻塞会不会”,答不会。
边界辨析:
nop的延迟 /nop的代价
- 延迟:5 拍,走完全部段
- 对程序的代价:1 拍
这是”延迟 ≠ 吞吐”最直接的一个例子。
边界辨析:RAW / WAR / WAW
五段顺序流水线只会出现 RAW。 WAR 和 WAW 需要乱序执行才会发生,用寄存器重命名解决,见 5.6.5。
题目若在五段流水线的背景下问 WAR,答不会发生。
对照速查
| 距离 | 无转发时停顿 | 有转发时停顿 |
|---|---|---|
| 相邻(1) | 2 拍 | 0(LW 后为 1 拍) |
| 距离 2 | 1 拍 | 0 |
| 距离 3 | 0 或 1(看寄存器堆是否前写后读) | 0 |
| 距离 ≥4 | 0 | 0 |
| 说法 | 判断 |
|---|---|
| 数据转发能解决所有 RAW 冒险 | ❌ load-use 仍需停 1 拍 |
插入 nop 增加了指令条数 | ✅ IC ↑ |
| 硬件阻塞增加了指令条数 | ❌ CPI ↑ |
| 五段流水线会出现 WAR 冒险 | ❌ |
| 2 位预测器一个循环只猜错一次 | ✅ 1 位要错两次 |
| 分支预测错误的代价是冲刷流水线 | ✅ |
| 结构冒险可以用分离 I/D Cache 解决 | ✅ |
| 延迟槽由硬件填充 | ❌ 由编译器填 |
考点
- 给指令序列判断冒险类型并算停顿拍数:本节最大的题型。步骤:①标出每条指令写哪个寄存器、读哪个寄存器;②找 RAW 对;③数距离;④按有无转发查表。
- load-use 冒险:必考的例外,转发也要停 1 拍。
- 画带停顿的时空图:气泡要画出来。
- 四种数据冒险手段的代价归属:IC / CPI / 硬件成本。
- 2 位预测器优于 1 位的理由:循环的最后一次与下一次的第一次。
- 延迟槽由谁填:编译器。
链接
- 🏠 返回总览:计算机组成原理第 5 章:中央处理器总览
- ⬅️ 上一节:5.6.2 流水线的基本实现
- ➡️ 下一节:5.6.4 流水线的性能指标
- 🚀 乱序与重命名:5.6.5 高级流水线技术
- 📐 三因子:1.3.1 计算机的主要性能指标
- 🔗 循环的回边:4.3.3 循环语句
- 🖼️ 配图:五级流水线冒险与处理图
- 📖 名词库:第 5 章名词库